
Вы на ступень ниже, чем думаете: аудит собственного внедрения ИИ
Каждый считает себя на ступень выше, чем стоит. Навык для Claude Code, который читает репозиторий вместо вашего самомнения и называет реально закрытую ступень.
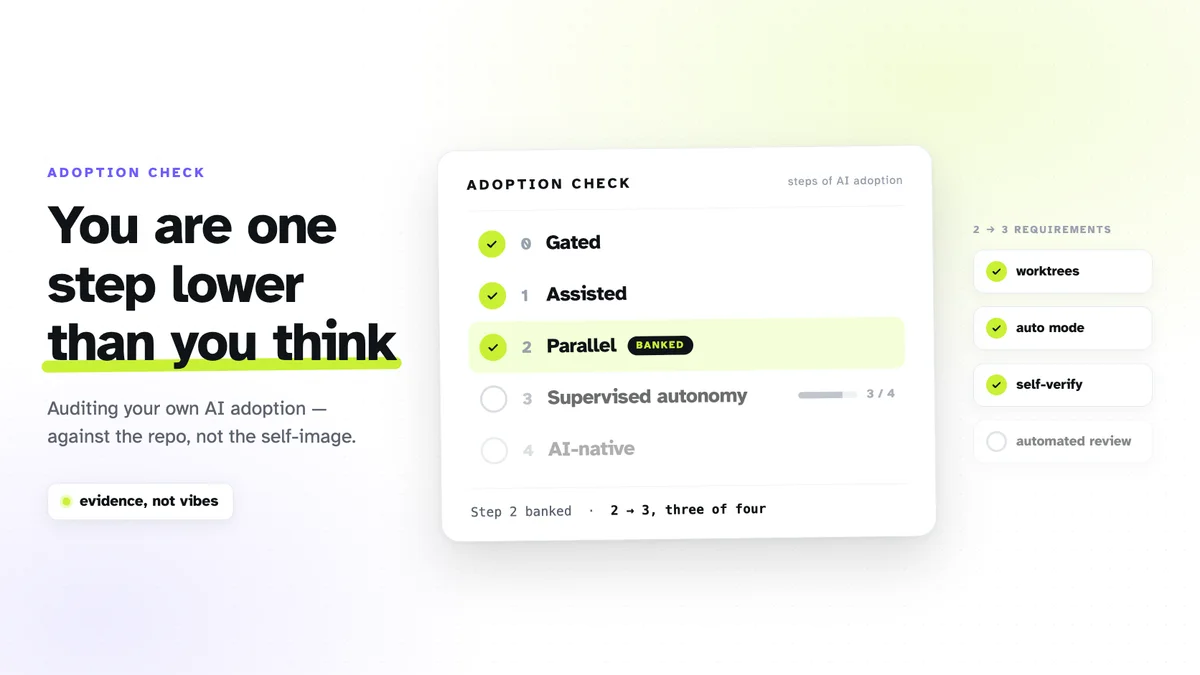
Спросите разработчика, насколько глубоко он ушёл в агентную разработку, и в ответ услышите про инструменты. Какая модель, какой редактор, сколько вкладок в терминале. Спросите, получает ли он от этого больше, чем три месяца назад, — и ответ превратится в туман.
У меня была та же проблема с собственной работой, и она была хуже, чем расплывчатость, — она была направленной. Я стабильно считал, что нахожусь на ступень выше, чем позволяли данные, потому что считал то, что я настроил, а не то, на что реально опирался. Агент по расписанию существовал — значит, засчитывается. Коннектор был настроен — значит, контекст подтягивается. Настройка была реальной. Опора — нет.
Поэтому я написал небольшой навык, который отвечает на этот вопрос, читая репозиторий, а не спрашивая меня. Он работает около минуты и ни разу мне не польстил.
Лестница
Рамка взята из «Steps of AI Adoption» Бориса Черни, и её ценность в том, что каждая ступень определяется тем, что ломается, а не тем, чем вы владеете.
| Ступень | Агентов в работе | Ваша роль | Во что упирается |
|---|---|---|---|
| 0 Заблокировано | 0 | — | процессы согласования |
| 1 С помощником | ~1 | ревьюер в паре | ваше внимание и низкое доверие |
| 2 Параллельно | ~10 | оркестратор | ревью N потоков диффов |
| 3 Контролируемая автономия | ~100 | менеджер менеджеров | доверие к контуру, пропускная способность решений |
| 4 AI-native | 1000+ | задавать намерение, следить по исключениям | ограничители под каждый тип работы, в масштабе |
Интересна последняя колонка. Подъём не снимает узкое место, а переносит его — ради этого ступени и стоит различать. На ступени 1 вас ограничивает скорость чтения кода. На ступени 2 — скорость ревью нескольких параллельных диффов, и поэтому переход состоит не в том, чтобы «запустить больше агентов», а в том, чтобы «собрать то, что ревьюит за вас». На ступени 3 ограничение перестаёт быть техническим вообще и становится доверием: работа начинается без вашей отмашки, и либо вы верите результатам, либо вся конструкция — театр.
Переходы конкретны — именно это делает их проверяемыми:
- 1 → 2: параллельные агенты в изолированных worktree, петля самопроверки, которой вы действительно доверяете, автоматический режим и автоматическое ревью.
- 2 → 3: расписания и рутины, агенты, запускающие других агентов, контекст, который подтягивается сам, а не вставляется руками (задачи, документы, коннекторы), и достаточно широкий периметр разрешений, чтобы агент не упирался в вас каждые четыре минуты.
- 3 → 4: автоматизация в масштабе домена — миграции, фаззинг, массовые исправления — с потолком стоимости на каждый процесс.
А описание роли на ступени 3 — та строка, которая перестроила для меня больше всего. Вопрос к работе агента перестаёт быть «ты прочитал код?» и становится «какого контекста не хватило модели?». Это другая работа. Это разница между ревью результата и улучшением условий, в которых результат получается.
Почему это должен был быть навык, а не чек-лист
Я пробовал чек-лист. Какое-то время он лежал у меня в заметке. Проблема чек-листа в том, что заполняете его вы сами — по памяти, щедро, в конце удачной недели.
Три свойства делают автоматическую версию оправданной.
Он читает репозиторий, а не ваше самомнение. Он смотрит список разрешений в
реальных файлах настроек и сообщает, в каком именно файле тот лежит. Он смотрит
объявленные серверы в .mcp.json и делает по одному дешёвому вызову на чтение
к каждому, чтобы понять, жива ли авторизация: настроенный, но протухший
коннектор идёт как открытый пункт, потому что функционально он такой и есть. Он
ищет трейлеры агента в телах последних пятнадцати коммитов, а не в
--oneline, который срезает ровно то, что нужно. Там, где сигнал вообще не
оставляет следа — параллельная работа в worktree в git не видна, — он говорит
об этом и спрашивает, а не додумывает.
Зачёт строгий. Ступень засчитана только тогда, когда выполнены все пункты перехода. Три из четырёх — это не «ступень 3, частично». Это ступень 2, и отчёт говорит именно так: «Ступень 2 засчитана; переход 2→3 — 3 из 4». Звучит как занудство и при этом остаётся самым полезным правилом во всей затее. Частичный зачёт — это то, как вы начинаете считать себя там, где вас нет: частичный зачёт — язык самооценки, и каждый незакрытый пункт в нём звучит почти закрытым.
Он помнит — по каждому проекту отдельно. Каждый запуск пишет обратно в память проекта: строку статуса с датой, срез доказательств, открытые пункты. Поэтому следующий запуск — это диф, а не свежая догадка, и у вопроса «сдвинулось ли что-то с июня?» появляется настоящий ответ. В той же памяти есть раздел «Решено ПРОТИВ — не предлагать снова». Если я оценил практику и отказался от неё по хорошим причинам, я хочу, чтобы отказ держался. Ассистент, который раз в месяц заново продаёт отвергнутую идею, не помогает, а делает слово «нет» дорогим.
Разделение по проектам оказалось важнее, чем я ожидал. Я честно нахожусь на разных ступенях в разных репозиториях, и усреднение их в один личный «уровень» уничтожает единственную полезную информацию. Зрелый сервис с тестами и широким периметром разрешений выдерживает работу без присмотра. Прототип двух недель от роду — нет, и не должен. Тот же разработчик, те же инструменты, разные ступени.
Что он на самом деле ловит
Инфраструктуру, засчитанную как прогресс. Это был мой собственный режим отказа, и по нему навык высказывается жёстче всего. Существующая рутина по расписанию — это не ступень 3. Ступень 3 держится на результатах без присмотра, которым доверяют. Поэтому навык проверяет, что рутина есть, включена и имеет разумный следующий запуск, — и на этом останавливается, потому что оставшийся вопрос может закрыть только человек: были ли последние отчёты точными и полезными? Ни один репозиторий на это не ответит. Если их никто не оценил, ступень не засчитана, и никакое количество зелёной конфигурации этого не меняет.
То, что выглядит настроенным, но не работает. Проверка авторизации ловит коннекторы, которые когда-то настроили, а они тихо перестали работать. Найти это так дешевле, чем посреди работы, в которой вы на них рассчитывали.
Утечку области видимости. MCP-инструменты, видимые в сессии, могут прийти из пользовательской конфигурации или вообще из другого проекта — они не являются доказательством про этот репозиторий. Ограничение аудита файлами, памятью и триггерами текущего проекта пришлось прописать явно, потому что соблазнительная ошибка здесь — позволить хорошо оснащённой сессии польстить голому репозиторию.
Есть и обратный режим отказа, на исправление которого ушло пара запусков. Ранние версии считали отсутствие инфраструктуры у молодого проекта недостатком и выдавали отчёт, который читался как выговор. Это бесполезно. Для свежего репозитория правильный ответ — «ступень 1, и вот кратчайший путь ко второй»: стартовая позиция, а не недостача.
Что вы с этого получаете
Честную ступень с доказательством к каждому утверждению — путь к файлу, идентификатор триггера, ссылка на коммит, — чтобы можно было спорить с отдельной строкой, а не с вердиктом. Таблицу с оценкой требований следующей ступени, чтобы цель была списком из четырёх конкретных вещей, а не ощущением отставания. И три следующих шага по порядку — по количеству доверия, заработанного на единицу усилий; порядок правильный, потому что верхние ступени сделаны именно из доверия.
Переформулировка стоит больше, чем оценка. «Мне кажется, я должен выжимать из этого больше» — это тревога, с ней ничего не сделать. «Автоматическое ревью открыто, и это последний пункт между мной и ступенью 2» — это задача на вторник.
Навык короткий: один файл Markdown, лестница зашита внутрь, поэтому он никогда
не тратит ход на то, чтобы что-то заново скачать. Он
опубликован как gist,
путь установки и заметки — в README. Положите его в
~/.claude/skills/adoption-check/, и он будет работать в каждом проекте,
который вы откроете.
Запустите его там, где вам за себя спокойно. Там он информативнее всего.