
Поставьте дешёвое суждение перед дорогим: как типизированный фильтр снижает задержку и стоимость LLM-пайплайна
Три топовые модели совещаются пятнадцать секунд. Суждение за 300 мс перед ними отсекает мусор и снимает ожидание, в котором не нуждались 82% запусков.
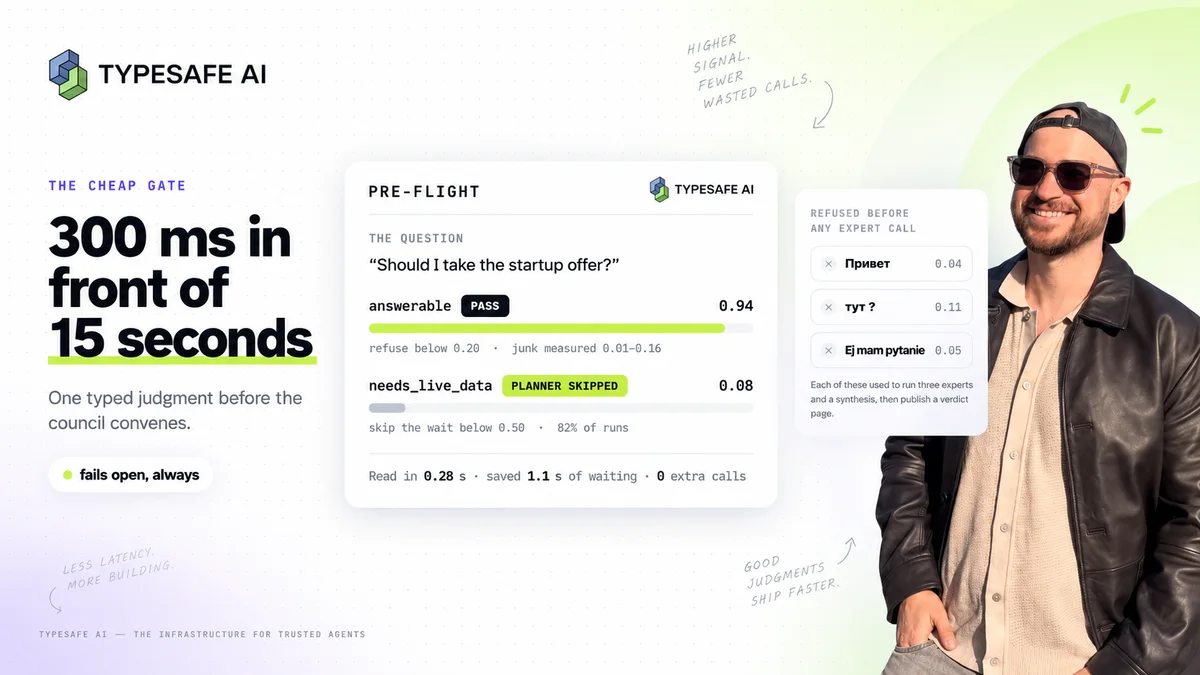
Council задаёт один и тот же вопрос трём топовым моделям параллельно, а потом сводит их ответы в один вердикт. Запуск занимает пятнадцать-двадцать пять секунд и стоит четыре платных вызова API. Это и есть продукт, и медлительность здесь не баг: вы смотрите, как совет совещается.
Беда конвейера такой формы в том, что он берёт на себя обязательства до того, как кто-нибудь посмотрел на вход. Все пятнадцать секунд достаются любому вопросу — включая те, что не стоили четырёх вызовов, и те, что вопросами вообще не были.
Вчера я поставил перед этим конвейером суждение на 300 мс. Не четвёртую модель в совете, а привратника: один вызов, который отвечает на два вопроса «да/нет» о сыром вводе и отдаёт коду две вероятности. Дальше — сам паттерн, цифры за каждым решением и два места, где я попробовал и отступил.
Две траты в начале каждого запуска
Планировщик исследования. Части вопросов нужны свежие факты — курсы, погода, расписания, всё, что случилось после даты обучения модели. Небольшой вызов Gemini решает, надо ли что-то искать, и если надо — пишет поисковые запросы. Он идёт параллельно с проверкой квоты, и веер экспертов не может стартовать, пока оба не завершатся: медиана 1 087 мс, максимум 2 532 мс при дедлайне 4 с.
Реально исследование нужно 18% продакшен-запусков — 24 из 135 за тридцать дней. То есть 82% запусков платят секунду задержки за ответ «нет».
Не-вопросы. Никто не проверял, что на входе вопрос. «Привет», «тут ?»,
«Ej mam pytanie» и «عطني معلومات اول مره اسمعها» — каждый из них прогнал трёх
экспертов и синтез, занял пятнадцать-двадцать пять секунд, стоил четыре
вызова и сохранился публичной страницей вердикта /s/[id] — в sitemap, где
Google мог проиндексировать вдумчивое совещание совета по слову «привет».
Это один и тот же баг. У конвейера не было дешёвого мнения о собственном входе.
Паттерн: 300 мс суждения, потом 15 секунд рассуждения
Впереди не может стоять ещё одна чат-модель. Маленькая LLM возвращает текст, значит его надо парсить, значит вы получаете проблему некорректного вывода ровно в том месте, которое обязано быть надёжным, — и платите секунду задержки, чтобы сэкономить секунду задержки.
Работает модель, у которой вывод уже типизирован. Я взял Jev от TypeSafe — модель System One: она читает естественный язык и возвращает калиброванные вероятности по ответам, которые вы сами определили, без текста и без следа рассуждений. Один POST, пять вопросов в теле, и форма ответа — контракт, а не надежда.
Весь вызов — это текст вопроса, сегодняшняя дата и примерный город спрашивающего:
const result = await askSystemOne(
  { question, today, approximate_user_location },
  { answerable, needs_live_data, stakes, taste, pick },
  { signal: AbortSignal.timeout(1_500), label: "preflight" }
);
Замеры по 46 вопросам: медиана 283 мс, максимум 933 мс. Вызов идёт рядом с проверкой квоты, которую запуск и так ждал, так что на счастливом пути он не стоит ничего.
Дальше решает код, а не модель:
answerableниже 0.2 — запуск отклонён до первого вызова эксперта.needs_live_dataниже 0.5 — планировщика не ждём и идём без исследования.
Выбирайте примитив, а не промпт
С первого подхода я ошибся именно здесь: полез придумывать промпт там, где надо было выбирать тип возвращаемого значения. System One даёт три, и выбор идёт по тому, что означает ответ:
| Примитив | Что возвращает | Для чего |
|---|---|---|
| Noul | P(да), без отдельной уверенности | Выполняется ли условие |
| Score | Распределение по упорядоченным уровням | Степень по описанной шкале |
| Choice | Один вариант плюс распределение по всем | Один из заданного набора |
Оба вопроса привратника — Noul, потому что оба действительно «да/нет». Noul на 0.5 не значит «средне»: он значит, что «да» и «нет» равновероятны, а для привратника это как раз то чтение, которое нужно.
Мусор от настоящего вопроса отделила не инструкция. Отделили критерии — с примерами:
answerable: {
  type: "noul",
  instructions:
    "Is `question` an actual question or decision a panel of advisors could " +
    "give a useful verdict on, rather than a greeting, a test message, a " +
    "fragment with no ask, or noise?",
  criteria: {
    true: {
      what: "Contains a real ask, even if short or badly phrased",
      examples: ["Тонзилгон применение", "Buy or rent in Madrid?"],
    },
    false: {
      what: "Greeting, 'are you there', 'I have a question' with no question, gibberish",
      examples: ["Привет", "hello?", "I have a question"],
    },
  },
}
Эти примеры несут нагрузку. «Тонзилгон применение» — два слова, без глагола
и без знака вопроса, и при этом настоящий запрос: 0.91. «Ej mam pytanie» —
гладкое польское предложение, которое ни о чём не спрашивает: 0.05. Без
примеров модель читает пунктуацию и беглость; с ними — читает, есть ли
запрос. Это одна правка в criteria, а не промпт-инжиниринг.
Пороги измеряют, а не угадывают
0.2 и 0.5 выглядят произвольными — так и есть, если просто их записать.
Обоснованными их делает то, что оба стоят в измеренном зазоре.
| Привратник | Порог | Мусор / негативы | Настоящие / позитивы |
|---|---|---|---|
answerable |
0.2 | 0.01 – 0.16 | ≥ 0.63, в основном ≥ 0.9 |
needs_live_data |
0.5 | ≤ 0.70 | ≥ 0.92 |
Фикстура планировщика — тридцать вопросов, половина требует поиска. Все позитивы получили 0.92 и выше, все негативы 0.70 и ниже, так что у порога 0.5 есть запас 0.2 с каждой стороны — я могу двигать его далеко, прежде чем какой-нибудь класс его перейдёт.
Но результат — не порог. Результат — бенч-скрипт. Он прогоняет оба привратника по фикстурам и валит сборку при recall ниже 1.0, precision ниже 0.9, любом пропущенном мусоре, любом отклонённом коротком настоящем вопросе или медиане выше 600 мс. Текущий прогон: precision 0.94, recall 1.00, медиана 296 мс.
Именно этот бенч превращает число в продуктовое решение, а не в суеверие. Порог, за которым нет бенча, — это догадка, которую вы через три месяца побоитесь тронуть.
Политику держите в коде, где её можно менять бесплатно
С калиброванной моделью хочется спросить у неё вывод. Не надо: спрашивайте суждение, а вывод оставьте своему коду — потому что менять вы будете как раз вторую половину.
Council ещё спрашивает у Jev, насколько решение обратимо, — это Score по трём уровням: легко отменить, дорого отменить, дверь в одну сторону. Очевидное чтение — ожидаемый уровень, который отдаёт API. И оно неверное. Вопрос, разделённый 50/50 между уровнями «легко отменить» и «дверь в одну сторону», даёт ожидание 1.0, которое округляется до «дорого отменить» — уровня, который модель сочла наименее вероятным из трёх.
Поэтому политика — одна строка кода: берём корзину с наибольшей вероятностью, а при точном равенстве оставляем уровень ниже.
// argmax по распределению, а не округлённое ожидание
for (const l of [0, 1, 2] as const) {
  const p = stakes.probabilities[String(l)];
  if (p !== undefined && p > best) { best = p; level = l; }
}
То же с порогами для отображения. Читается вопрос как «в основном личный
вкус» или «в основном факты» — это TASTE_MIN = 0.6 и FACTS_MAX = 0.4 в
блоке констант. Сдвинуть любой из них — деплой, а не перезапуск вывода:
данные и смысл вопроса не изменились, пересчитывать нечего. Сырые суждения
остаются переиспользуемыми, политика — явной и дешёвой.
Сбой должен пропускать запрос, иначе не отправляйте это в прод
Привратник перед работающим конвейером — это новый способ его сломать.
Правило, которое я не гну: любой путь сбоя возвращает null, а null
значит, что маршрут ведёт себя ровно так, как до появления привратника.
Нет ключа, таймаут 1,5 с, HTTP-ошибка после одного ретрая, тело не JSON — всё это пишет предупреждение и не даёт вердикта, а «нет вердикта» значит «нет отказа и нет пропуска планировщика». Фича выключается удалением переменной окружения.
Две детали заслужили место:
Один ретрай, дальше стоп. 408, 429, 5xx и 529 TypeSafe («перегрузка») повторяются один раз через 300 мс. Не два — дедлайн вызывающего 1,5 с, так что второй ретрай в него уже не попадёт никогда. Политика ретраев — функция от дедлайна, а не от того, что кажется надёжным.
Кривой ответ выбрасывается, а не бросает исключение. В одном запросе пять вопросов, и два вопроса привратника едут в том же теле, что три пользовательских. Если тело не объект или в нём вообще нет ответов — это исключение. Но один ответ, не прошедший валидацию, просто выкидывается с одним предупреждением, а остальные доходят до своих вызывающих. Иначе одно плохое чтение для косметической фичи стоило бы запуску привратника «а это вообще вопрос» — радиус поражения от тела, которое я не контролирую, был бы равен всему конвейеру.
И логируйте решение. Каждый запуск после проверки квоты записывает обе вероятности, что маршрут с ними сделал и — если планировщика ждали — вердикт самой Gemini по тому же вопросу. Согласие Jev и Gemini теперь запрос, а не вера. Я уже отправлял в прод правило маршрутизации на числе, которое ни разу не проверил, и повторять не хочется.
Когда через привратника идёт каждый ввод, лишние вопросы почти бесплатны
Неожиданный дивиденд: дорогая часть этого паттерна — круговая поездка, а не количество вопросов. Если каждый отправленный вопрос и так идёт в Jev, то дополнительные суждения по тому же состоянию почти ничего не стоят и считаются параллельно — они не видят ответов друг друга, так что за порядок платить не надо.
Привратник Council вырос с двух вопросов до пяти: два привратника, плюс насколько решение обратимо, плюс на чём оно держится — на вкусе или на фактах, плюс — когда в вопросе названы варианты — какой из них выбрал бы Jev. Медиана выросла с 283 мс до 313 мс, p90 710 мс, максимум 851 мс.
Эти три дополнительных чтения — уже пользовательская фича. Карточка «Инстинкт» появляется над местами экспертов примерно через полсекунды после отправки: пилюли ставок и вкуса, полоска на вариант, пока совет ещё думает — мгновенное суждение рядом с совещанием, а позже строка о том, согласился ли с ним совет. Бюджет задержки на это был нулевой: запрос всё равно был в полёте ради привратника.
Вот эту часть стоит украсть даже без привратника: если вы уже платите за круговую поездку к модели суждений, спросите заодно всё, что захотите знать об этом состоянии.
Два места, где не сработало
Поиск недостающего контекста. Идея была замечать, что в вопросе нет единственного факта, который всё решает, и спрашивать пользователя до запуска совета. Ответы Jev пришли с уверенностью 0.2–0.6 — распределение слишком плоское, чтобы ставить порог. Это сигнал переделать вопрос и собрать размеченный набор, а не отправлять в прод по заниженной планке. Вырезано.
Полная замена планировщика. Модель суждений возвращает суждения, а не
поисковые запросы, а шагу исследования нужны именно запросы. Поэтому «да» на
needs_live_data по-прежнему ждёт Gemini, как и раньше. Привратник убрал
ожидание только на тех 82% запусков, которым всё равно предстояло получить
«нет», — в чём и был весь выигрыш, и это утверждение куда скромнее, чем «мы
заменили модель».
Одну вещь скажу прямо: вызов привратника отправляет текст вопроса, дату и примерный город. Он никогда не отправляет id пользователя, анонимные id, id сессии или email. Но у этого API сегодня нет флага нулевого хранения на запрос — в отличие от поискового вызова, который этот же конвейер делает в другом месте, — так что эти данные лежат под стандартным сроком хранения провайдера. Это должно попасть в ваш текст о приватности раньше, чем фича попадёт в прод.
Что переносится
Если у вас дорогой AI-конвейер — несколько моделей, длинная цепочка, что угодно, где один ввод стоит настоящих денег и настоящих секунд:
- Найдите, на что конвейер соглашается до того, как что-то знает. В Council это ожидание планировщика и непроверенный ввод. Оба видны в продакшен-данных, которые у меня уже были.
- Ставьте привратника с типизированным выводом, а не с текстом. То, что стоит впереди, обязано быть надёжнее того, что оно защищает.
- Выбирайте примитив по смыслу ответа. Условие, степень или один из набора.
- Примеры кладите в критерии. Точность пришла оттуда.
- Измерьте зазор, поставьте порог внутри него — и сохраните бенч.
- Сбой пропускает запрос на любом пути, решение — в лог.
Честная оговорка: за проблемой стоят бенч-цифры и тридцать дней продакшен-истории, но сам привратник живёт в проде один день. Я знаю, что он отклоняет мусор и снимает ожидание планировщика. А согласуется ли суждение за 300 мс с тремя топовыми моделями достаточно часто, чтобы расширять его роль, — это запрос, который я пока не могу выполнить, и я записал, что понадобится на ответ, прежде чем делать с ним что-то ещё.
Council работает на trycouncil.app, в App Store и в Google Play. Если у вас есть AI-конвейер, который платит полную цену за входы, того не стоящие, и хочется взгляд со стороны на то, куда поставить дешёвого привратника, — напишите мне.