
Уверенность Claude, GPT и Gemini: самая неуверенная модель в 222 сессиях Council
Три ИИ-модели отвечают на один и тот же вопрос по одному промпту. Одна из них оказывается наименее уверенной в 95% случаев — и это не та, которую переголосовывают.
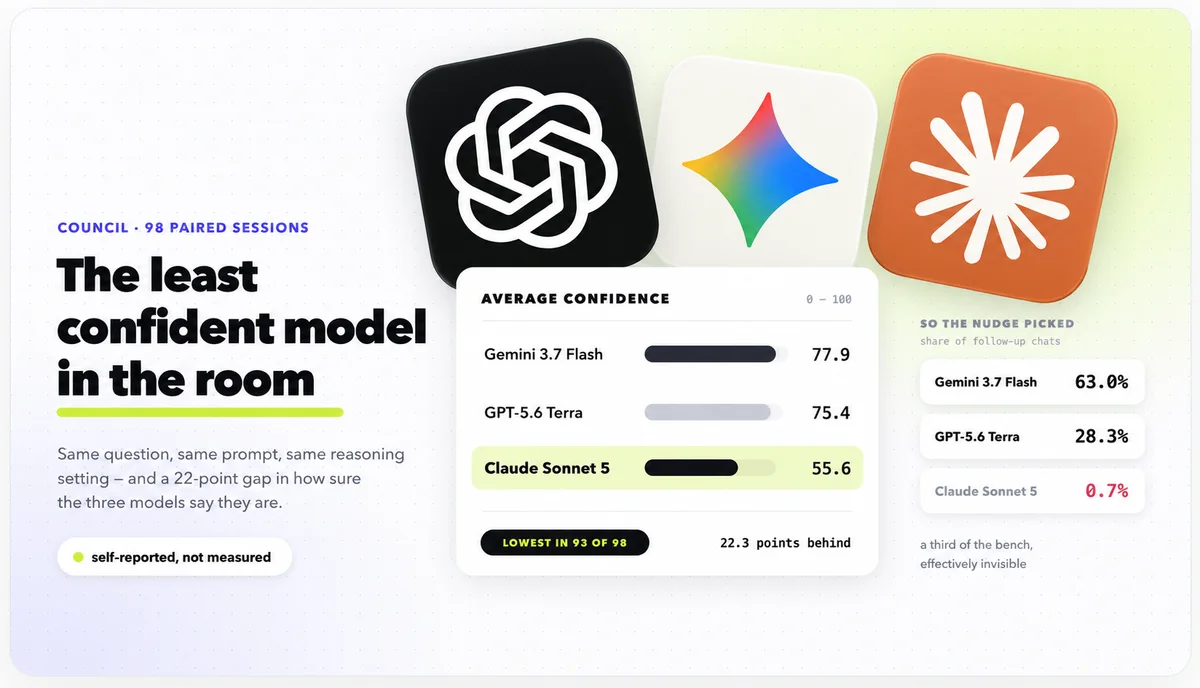
Council задаёт один и тот же вопрос трём ИИ-моделям и сводит их ответы в один вердикт. Каждая модель возвращает одинаковую структуру: рекомендацию, обоснование и уверенность — число от 0 до 100.
Это число должно было стать самым дешёвым полезным сигналом во всём продукте. Оно приходит бесплатно вместе с ответом, за который я и так плачу, это одно целое число, и кажется, что смысл у него очевидный. Я сортировал по нему. Два дня назад я на его основе решил, какого советника показывать людям первым.
Потом я посчитал это по всем сессиям в базе — и оказалось, что число значит совсем не то, на что похоже.
Почему эти сессии — честное сравнение
Условия здесь чище, чем в большинстве сравнений моделей, причём по случайности, а не по замыслу.
Каждое место за столом получает идентичный системный промпт, идентичную JSON-схему, идентичное указание отвечать на языке пользователя и идентичную минимальную настройку рассуждений для своего провайдера. Модели работают параллельно над одним и тем же вопросом — не бенчмарочным, а настоящим, который кто-то напечатал. Ничто в этой схеме не даёт преимущества ни одному месту, и ничто в ней не меняется, кроме самой модели.
Из 222 сессий с июня в 98 за столом сидел состав по умолчанию — все три модели вместе. Это 98 парных сравнений: один вход, три выхода, три самооценки.
Claude — наименее уверенный участник в 95% случаев
| Модель | Средняя уверенность | Наименее уверенный | Сессий с ≤50 |
|---|---|---|---|
| Gemini 3.7 Flash | 77,9 | 4 из 98 | 3 |
| GPT-5.6 Terra | 75,4 | 1 из 98 | 0 |
| Claude Sonnet 5 | 55,6 | 93 из 98 | 30 |
Claude Sonnet 5 оказался самым уверенным ровно в одной сессии из 98. Средний разрыв между ним и Gemini на одном и том же вопросе — 22,3 пункта.
Первая мысль была, что дело в том, кто спрашивал. В базе есть аккаунт с 50 сессиями — почти наверняка моё собственное тестирование, и если он задавал вопросы, неудобные для Claude, это могло перекосить всю картину. Я его убрал: остаётся 93 сессии от 79 разных людей, и средние почти не двигаются — 78,0, 75,1, 55,1, а Claude наименее уверен в 89 случаях из 93. Дело не в манере одного человека задавать вопросы. Дело в модели.
Очевидное объяснение не работает
Красивая версия звучала бы так: Claude — штатный диссидент за столом, он менее уверен, потому что систематически оказывается в меньшинстве, и низкая уверенность — честный отчёт о том, что ты единственный против всех.
Против этого в данных есть две вещи.
Ни одна лаборатория не является постоянным диссидентом. Когда синтезатор описывает, в чём панель разошлась, он обычно называет, кто именно выбился из общего ряда. На 222 сессии он называет OpenAI 163 раза, Google — 158, Anthropic — 154. Ровнее три числа распределить трудно. Несогласие — это не один против двоих, оно реально размазано по всему столу.
Уверенность и согласие упорядочены по-разному. Если бы оценка отражала «меня сейчас переголосуют», самая уверенная модель чаще прочих поддерживала бы итоговый вердикт. Но нет:
| Модель | Средняя уверенность | Поддержала вердикт |
|---|---|---|
| Gemini 3.7 Flash | 77,9 (максимум) | 82,4% |
| GPT-5.6 Terra | 75,4 | 91,7% (максимум) |
| Claude Sonnet 5 | 55,6 | 74,8% |
Gemini — самый уверенный участник за столом и при этом соглашается с остальными реже, чем GPT. Порядки расходятся именно наверху — там, где настоящий сигнал обязан был бы устоять.
Значит, число измеряет не свойство ответа. Оно измеряет свойство лаборатории: то, как конкретную модель научили говорить о собственной уверенности. Модель Anthropic хеджирует. Модель Google — нет. Поставьте их рядом под одинаковым промптом, и вы читаете два диалекта, а не два измерения.
Хочу быть точным в формулировке, потому что её легко раздуть. Речь о самооценке уверенности, при одном промпте, на минимальной настройке рассуждений у каждого провайдера, на вопросах про жизненные решения. Это не утверждение, что Claude хуже, лучше откалиброван или честнее. Утверждение уже и практичнее: эти числа несопоставимы между вендорами, и любой код, который ранжирует модели по ним, сортирует по стилю дома, а не по сути.
Ровно это я и выкатил накануне.
Фича, которую я сломал, поверив собственному числу
За день до этого запроса я выкатил небольшую вещь в оба приложения. Чат с советником — где можно один на один продолжить разговор с участником панели — живёт под всеми карточками экспертов, и почти никто не докручивал до него. За всё время дополнительные вопросы были в 12 сессиях из 222. Поэтому я добавил карточку прямо под вердиктом: она называет самое острое расхождение и заранее выбирает советника, с которым стоит поспорить.
Какого советника? Самого уверенного. Когда я это писал, решение выглядело самоочевидным: отправляй людей к тому, кто больше всех уверен в себе.
Прогоняю это правило по всем 138 сессиям:
| Кого выбрала бы карточка | Доля |
|---|---|
| Gemini 3.7 Flash | 63,0% |
| GPT-5.6 Terra | 28,3% |
| Gemini 3.1 Flash-Lite | 7,2% |
| Claude Sonnet 5 | 0,7% — одна сессия из 138 |
Я построил фичу, которая отправляет практически все дополнительные разговоры в Google — на основании числа, которое говорит лишь о том, что модель Google разговорчивее насчёт собственной уверенности. Треть моего же состава за ней не видна. И это работает в продакшене прямо сейчас. Никто никогда не сообщил бы об этом как о баге: снаружи это просто карточка с именем.
Починка — не более удачная функция ранжирования по тому же числу. Починка в том, чтобы перестать ранжировать по нему: спорить интереснее всего с тем, кто не согласился, а несогласие я вижу напрямую в массиве голосов, и его не надо выводить из самоотчёта.
Заодно: панель не согласилась ни разу
Из того же запроса выпали ещё две вещи, и одна из них — мёртвый код, о котором я не знал, что написал его.
У карточки есть ветка, которая прячет её, если совет единогласен: указывать не на что. Эта ветка не выполнялась никогда. Из 138 сессий с текущей схемой ни в одной список расхождений не пуст. Ни в одной. В среднем на сессию приходится 3,1 явного разногласия, и при этом:
- В 76% сессий хотя бы по одному из трёх предложенных вариантов голоса разделились.
- В 38% не нашлось ни одного варианта, который поддержали бы все три модели.
- Оценки консенсуса идут от 35 до 100 при среднем 77,8.
Я написал защиту для случая, которого в реальности не существует. Три фронтир-модели, получив настоящее решение и обязанность дать рекомендацию, находят повод разойтись каждый раз.
Часть, которая оправдывает продукт
Последняя находка — та, которую я не искал.
Карьерные вопросы — самая большая категория в Council с большим отрывом, 29,3% всех сессий, вдвое больше следующей. И это же категория, в которой модели сходятся меньше всего:
| Категория | Средний консенсус |
|---|---|
| Учёба | 93,9 |
| Здоровье | 82,1 |
| Быт и образ жизни | 81,3 |
| Технологии | 76,3 |
| Деньги | 76,0 |
| Карьера | 72,4 |
| Творчество | 69,6 |
То, по чему людям больше всего нужно второе мнение, — ровно то, где ответ одной модели хуже всего представляет мнение моделей в целом. Если бы панель сходилась по карьере, Council был бы дорогим способом сделать то, что уже делает один API-вызов. Она не сходится — значит, не является.
Это самый сильный аргумент в пользу продукта, который у меня есть, и я его не
придумал — я нашёл его в GROUP BY.
Честные оговорки
Это 222 сессии от 109 человек, из которых платят трое. Выборка маленькая. Часть ранних сессий — моё же тестирование одного примера на разных языках. За несколькими строками таблицы категорий стоит меньше 20 сессий, и разницу между «здоровьем» и «бытом» я не стал бы защищать ни секунды.
Но главному результату не нужна большая выборка — ему нужна парная. 93 из 98, которые держатся как 89 из 93 на 79 несвязанных людях, — это не артефакт выборки. Как и фича, отправляющая 0,7% трафика к трети собственного состава.
Что я сказал бы тем, кто строит на нескольких моделях
Не сравнивайте самооценку уверенности между вендорами и никогда не пускайте её в маршрутизацию, ранжирование, сортировку и решение о том, за кем последнее слово. Внутри одной модели она ещё может нести информацию: собственные 15 и собственные 95 у Claude, скорее всего, значат разное. Между моделями это перевод единиц, которого никто не определял, и код, считающий эти числа взаимозаменяемыми, тихо заведёт себе любимую лабораторию.
Более общий вывод старше и скучнее самой находки. Я выкатил правило маршрутизации в один день, потому что оно было очевидно верным, и опроверг его на следующий запросом, который мог сделать сразу. Запрос занял четыре минуты. Всё, что ему требовалось, уже лежало в базе — нетронутым, всё то время, пока фичу писали и ревьюили.