
Postaw tani sąd przed drogim: jak typowana bramka obniża opóźnienia i koszty pipeline’u LLM
Trzy czołowe modele naradzają się piętnaście sekund. Sąd wydany w 300 ms przed nimi odsiewa śmieci i zdejmuje czekanie, którego 82% uruchomień nie potrzebowało.
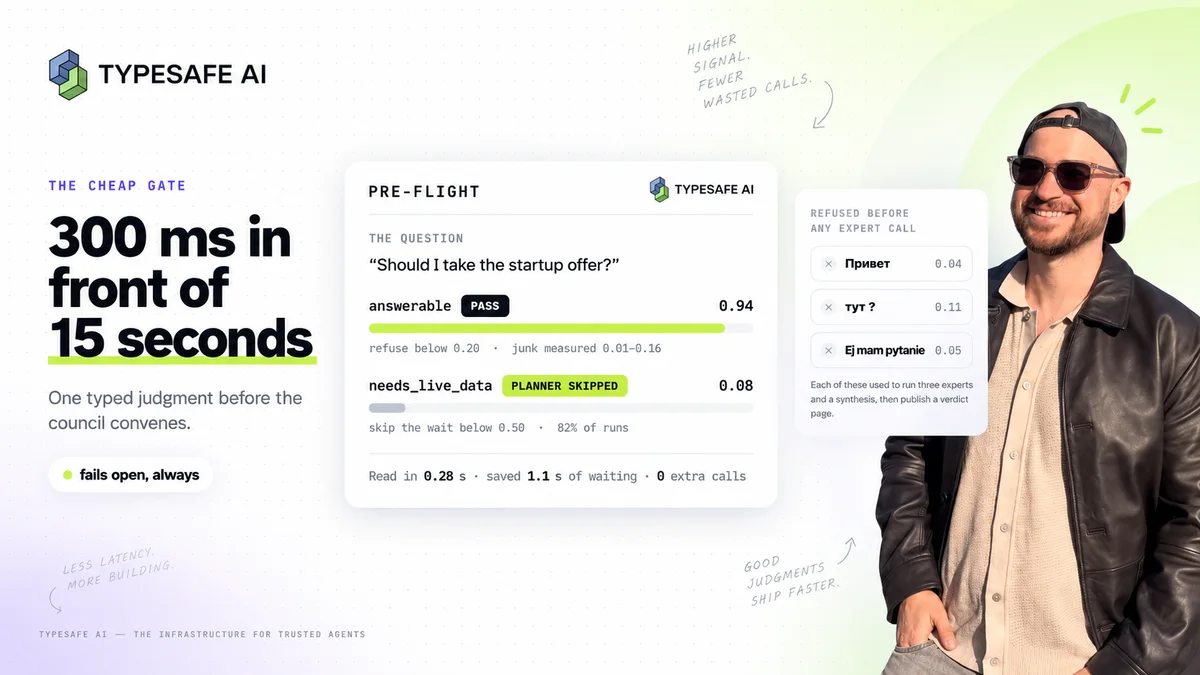
Council zadaje to samo pytanie trzem czołowym modelom równolegle, a potem scala ich odpowiedzi w jeden werdykt. Jedno uruchomienie trwa piętnaście do dwudziestu pięciu sekund i kosztuje cztery płatne wywołania API. To jest produkt, a ta powolność jest celowa — patrzysz, jak rada się naradza.
Kłopot z potokiem o takim kształcie polega na tym, że zobowiązuje się, zanim cokolwiek spojrzy na wejście. Każde pytanie dostaje pełne piętnaście sekund — także te, które nie były warte czterech wywołań, i te, które wcale nie były pytaniami.
Wczoraj postawiłem przed nim sąd wydawany w 300 ms. Nie czwarty model w radzie, a bramkarza: jedno wywołanie, które odpowiada na dwa pytania „tak/nie” o surowe wejście i wręcza kodowi dwa prawdopodobieństwa. Poniżej sam wzorzec, liczby stojące za każdą decyzją i dwa miejsca, w których spróbowałem i się wycofałem.
Dwa marnotrawstwa na początku każdego uruchomienia
Planer wyszukiwania. Część pytań potrzebuje bieżących faktów — kursów, pogody, rozkładów, wszystkiego, co zdarzyło się po dacie odcięcia wiedzy modelu. Małe wywołanie Gemini decyduje, czy trzeba czegoś poszukać, i jeśli tak, pisze zapytania. Idzie równolegle z kontrolą limitu, a wachlarz ekspertów nie może wystartować, dopóki oba się nie zamkną: mediana 1 087 ms, maksimum 2 532 ms, przy terminie 4 s.
Wyszukiwania potrzebuje 18% produkcyjnych uruchomień — 24 na 135 w ciągu trzydziestu dni. Czyli 82% uruchomień płaci sekundą opóźnienia za odpowiedź „nie”.
Nie-pytania. Nic nie sprawdzało, czy na wejściu jest pytanie. „Привет”,
„тут ?”, „Ej mam pytanie” i „عطني معلومات اول مره اسمعها” — każde z nich
przepuściło trzech ekspertów i syntezę, zajęło piętnaście do dwudziestu pięciu
sekund, kosztowało cztery wywołania i zostało zapisane jako publiczna strona
werdyktu /s/[id] — w sitemapie, gdzie Google mógł zaindeksować staranną
naradę rady nad słowem „cześć”.
To ten sam błąd. Potok nie miał taniej opinii o własnym wejściu.
Wzorzec: 300 ms sądu, potem 15 sekund rozumowania
Z przodu nie może stać kolejny model czatowy. Mały LLM zwraca tekst, czyli trzeba go parsować, czyli bierzesz na siebie problem zniekształconego wyjścia dokładnie w tym miejscu, które musi być niezawodne — i płacisz sekundą opóźnienia, żeby zaoszczędzić sekundę opóźnienia.
Działa model, którego wyjście jest już typowane. Wziąłem Jev od TypeSafe — model System One: czyta język naturalny i zwraca skalibrowane prawdopodobieństwa dla odpowiedzi, które sam definiujesz, bez tekstu i bez śladu rozumowania. Jeden POST, pięć pytań w ciele, a kształt odpowiedzi jest kontraktem, nie nadzieją.
Całe wywołanie to treść pytania, dzisiejsza data i przybliżone miasto pytającego:
const result = await askSystemOne(
  { question, today, approximate_user_location },
  { answerable, needs_live_data, stakes, taste, pick },
  { signal: AbortSignal.timeout(1_500), label: "preflight" }
);
Pomiary na 46 pytaniach: mediana 283 ms, maksimum 933 ms. Wywołanie idzie obok kontroli limitu, na którą uruchomienie i tak czekało, więc na szczęśliwej ścieżce nie kosztuje nic.
Dalej decyduje kod, nie model:
answerableponiżej 0.2 odrzuca uruchomienie przed pierwszym wywołaniem eksperta.needs_live_dataponiżej 0.5 przestaje czekać na planer i rusza bez wyszukiwania.
Wybieraj prymityw, nie prompt
Za pierwszym podejściem pomyliłem się dokładnie tutaj: sięgnąłem po prompt tam, gdzie należało wybrać typ zwracanej wartości. System One daje trzy, a wybór zależy od tego, co znaczy odpowiedź:
| Prymityw | Co zwraca | Do czego |
|---|---|---|
| Noul | P(tak), bez osobnej pewności | Czy warunek zachodzi |
| Score | Rozkład po uporządkowanych poziomach | Stopień na opisanej skali |
| Choice | Jedna opcja plus rozkład po wszystkich | Jedna z zadanego zbioru |
Oba pytania bramkarza to Noule, bo oba są naprawdę „tak/nie”. Noul na 0.5 nie znaczy „średnio” — znaczy, że „tak” i „nie” są równie prawdopodobne, a dla bramkarza to dokładnie ten odczyt, którego chcesz.
Prawdziwe pytanie od szumu oddzieliła nie instrukcja. Oddzieliły kryteria — z przykładami:
answerable: {
  type: "noul",
  instructions:
    "Is `question` an actual question or decision a panel of advisors could " +
    "give a useful verdict on, rather than a greeting, a test message, a " +
    "fragment with no ask, or noise?",
  criteria: {
    true: {
      what: "Contains a real ask, even if short or badly phrased",
      examples: ["Тонзилгон применение", "Buy or rent in Madrid?"],
    },
    false: {
      what: "Greeting, 'are you there', 'I have a question' with no question, gibberish",
      examples: ["Привет", "hello?", "I have a question"],
    },
  },
}
Te przykłady są nośne. „Тонзилгон применение” to dwa rosyjskie słowa, bez
czasownika i bez znaku pytania, a jednak prawdziwe pytanie: 0.91. „Ej mam
pytanie” to płynne polskie zdanie, które o nic nie pyta: 0.05. Bez
przykładów model czyta interpunkcję i płynność; z nimi czyta, czy jest
pytanie. To jedna poprawka w criteria, nie inżynieria promptów.
Progi się mierzy, nie zgaduje
0.2 i 0.5 wyglądają arbitralnie i — tak zapisane — są. Uzasadnionymi czyni
je to, że oba siedzą w zmierzonej luce.
| Bramkarz | Próg | Śmieci / negatywy | Prawdziwe / pozytywy |
|---|---|---|---|
answerable |
0.2 | 0.01 – 0.16 | ≥ 0.63, w większości ≥ 0.9 |
needs_live_data |
0.5 | ≤ 0.70 | ≥ 0.92 |
Zestaw testowy planera to trzydzieści pytań, połowa wymaga wyszukiwania. Każdy pozytyw dostał 0.92 lub więcej, każdy negatyw 0.70 lub mniej, więc próg 0.5 ma 0.2 zapasu z obu stron — mogę go przesuwać daleko, zanim któraś z klas go przekroczy.
Ale produktem nie jest próg. Produktem jest skrypt pomiarowy. Przepuszcza obu bramkarzy przez zestawy i wywala build przy recall poniżej 1.0, precision poniżej 0.9, jakimkolwiek przepuszczonym śmieciu, jakimkolwiek odrzuconym krótkim prawdziwym pytaniu albo medianie powyżej 600 ms. Bieżący przebieg: precision 0.94, recall 1.00, mediana 296 ms.
To ten pomiar zamienia liczbę w decyzję produktową, a nie w zabobon. Próg bez pomiaru za sobą to domysł, którego za trzy miesiące będziesz się bał tknąć.
Politykę trzymaj w kodzie, gdzie zmiana jest darmowa
Przy skalibrowanym modelu chce się zapytać go o wniosek. Nie rób tego — pytaj o sąd, a wniosek zostaw własnemu kodowi, bo to właśnie tę drugą połowę będziesz chciał zmieniać.
Council pyta Jev także o to, jak odwracalna jest decyzja — jako Score po trzech poziomach: łatwo odwrócić, kosztownie odwrócić, drzwi w jedną stronę. Oczywisty odczyt to oczekiwany poziom, który zwraca API. I jest błędny. Pytanie podzielone 50/50 między poziomami „łatwo odwrócić” i „drzwi w jedną stronę” daje oczekiwanie 1.0, które zaokrągla się do „kosztownie odwrócić” — poziomu, który model uznał za najmniej prawdopodobny z trzech.
Dlatego polityka to jedna linia kodu: bierzemy kubełek o najwyższym prawdopodobieństwie, a przy dokładnym remisie zostawiamy poziom niższy.
// argmax po rozkładzie, nie zaokrąglone oczekiwanie
for (const l of [0, 1, 2] as const) {
  const p = stakes.probabilities[String(l)];
  if (p !== undefined && p > best) { best = p; level = l; }
}
To samo z progami wyświetlania. Czy pytanie czyta się jako „głównie osobisty
gust”, czy „głównie fakty”, to TASTE_MIN = 0.6 i FACTS_MAX = 0.4 w bloku
stałych. Przesunięcie któregokolwiek to deploy, nie ponowne wnioskowanie:
dowody i znaczenie pytania się nie zmieniły, więc nie ma czego przeliczać.
Surowe sądy zostają wielokrotnego użytku, polityka zostaje jawna i tania.
Awaria musi przepuszczać, inaczej tego nie wdrażaj
Bramkarz przed działającym potokiem to nowy sposób, żeby ten potok zepsuć.
Zasada, której nie zginam: każda ścieżka awarii zwraca null, a null
znaczy, że trasa zachowuje się dokładnie tak, jak przed powstaniem
bramkarza.
Brak klucza, timeout 1,5 s, błąd HTTP po jednej ponownej próbie, ciało, które nie jest JSON-em — wszystko to zapisuje ostrzeżenie i nie daje werdyktu, a brak werdyktu znaczy brak odmowy i brak pominięcia planera. Funkcję wyłącza się usunięciem zmiennej środowiskowej.
Dwa szczegóły zasłużyły na swoje miejsce:
Jedna ponowna próba, potem stop. 408, 429, 5xx i 529 TypeSafe („przeciążenie”) powtarzają się raz po 300 ms. Nie dwa razy — termin wywołującego to 1,5 s, więc druga próba nigdy by się w nim nie zmieściła. Polityka ponawiania jest funkcją terminu, a nie tego, co wydaje się solidne.
Zniekształcona odpowiedź jest odrzucana, nie rzuca wyjątkiem. Jedno żądanie nosi pięć pytań, a dwa pytania bramkarza jadą w tym samym ciele co trzy pytania dla użytkownika. Jeśli ciało nie jest obiektem albo nie ma w nim żadnych odpowiedzi — to wyjątek. Ale jedna odpowiedź, która nie przechodzi walidacji, zostaje odrzucona z jednym ostrzeżeniem, a pozostałe docierają do swoich wywołujących. Inaczej jeden zły odczyt na potrzeby funkcji kosmetycznej kosztowałby uruchomienie bramkarza „czy to w ogóle pytanie” — promień rażenia ciała, którego nie kontroluję, byłby równy całemu potokowi.
I loguj decyzję. Każde uruchomienie po kontroli limitu zapisuje oba prawdopodobieństwa, to, co trasa z nimi zrobiła, oraz — gdy czekano na planer — własny werdykt Gemini o tym samym pytaniu. Zgodność Jev i Gemini jest teraz zapytaniem, a nie wiarą. Już raz wdrożyłem regułę routingu na liczbie, której nigdy nie sprawdziłem, i wolałbym nie powtarzać.
Gdy przez bramkarza idzie każde wejście, dodatkowe pytania są prawie darmowe
Nieoczekiwana premia: kosztowną częścią tego wzorca jest podróż w obie strony, a nie liczba pytań. Jeśli każde wysłane pytanie i tak idzie do Jev, to kolejne sądy o tym samym stanie kosztują prawie nic i liczą się równolegle — nie widzą odpowiedzi siebie nawzajem, więc nie ma za co płacić kolejnością.
Bramkarz Council urósł z dwóch pytań do pięciu: dwa pytania bramkarza, plus jak odwracalna jest decyzja, plus na czym się opiera — na guście czy na faktach, plus — gdy pytanie nazywa warianty — który z nich wybrałby Jev. Mediana wzrosła z 283 ms do 313 ms, p90 710 ms, maksimum 851 ms.
Te trzy dodatkowe odczyty to już funkcja dla użytkownika. Karta „Instynkt” pojawia się nad miejscami ekspertów około pół sekundy po wysłaniu: pigułki stawki i gustu, słupek na wariant, gdy rada jeszcze myśli — błyskawiczny sąd obok narady, a później linia o tym, czy rada się z nim zgodziła. Budżet opóźnienia na to był zerowy, bo żądanie i tak było w locie dla bramkarza.
To właśnie tę część warto ukraść, nawet jeśli nigdy nie zbudujesz bramkarza: jeśli już płacisz za podróż do modelu sądów, zapytaj przy okazji o wszystko, co będziesz chciał wiedzieć o tym stanie.
Dwa miejsca, w których nie wyszło
Wykrywanie brakującego kontekstu. Pomysł był taki, żeby zauważyć, że w pytaniu brakuje jednego faktu, który wszystko rozstrzyga, i dopytać użytkownika przed uruchomieniem rady. Odpowiedzi Jev wróciły z pewnością 0.2–0.6 — rozkład zbyt płaski, żeby stawiać próg. To sygnał, żeby przebudować pytanie i zebrać oznaczony zbiór, a nie wdrażać przy niższej poprzeczce. Wycięte.
Całkowite zastąpienie planera. Model sądów zwraca sądy, a nie zapytania
wyszukiwania, a krok wyszukiwania potrzebuje właśnie zapytań. Dlatego „tak”
na needs_live_data nadal czeka na Gemini, dokładnie jak wcześniej. Bramkarz
usunął czekanie tylko na tych 82% uruchomień, które i tak miały dostać „nie”
— w czym była cała wygrana, i co jest twierdzeniem znacznie skromniejszym niż
„zastąpiliśmy model”.
Jedna rzecz wprost: wywołanie bramkarza wysyła treść pytania, datę i przybliżone miasto. Nigdy nie wysyła identyfikatorów użytkownika, anonimowych identyfikatorów, identyfikatorów sesji ani adresów e-mail. Ale to API nie ma dziś flagi zerowej retencji na żądanie — w odróżnieniu od wywołania wyszukiwania, które ten sam potok wykonuje w innym miejscu — więc te dane leżą pod standardową retencją dostawcy. To musi trafić do twojego tekstu o prywatności wcześniej, niż funkcja trafi na produkcję.
Co się przenosi
Jeśli prowadzisz drogi potok AI — kilka modeli, długi łańcuch, cokolwiek, gdzie jedno wejście kosztuje prawdziwe pieniądze i prawdziwe sekundy:
- Znajdź, do czego potok się zobowiązuje, zanim cokolwiek wie. W Council było to czekanie na planer i niesprawdzone wejście. Oba dały się zmierzyć w danych produkcyjnych, które już miałem.
- Bramkuj typowanym wyjściem, nie tekstem. To, co stoi z przodu, musi być bardziej niezawodne niż to, co chroni.
- Wybieraj prymityw po znaczeniu odpowiedzi. Warunek, stopień albo jedna ze zbioru.
- Przykłady wkładaj do kryteriów. Stamtąd wzięła się dokładność.
- Zmierz lukę, postaw próg w jej środku — i zachowaj pomiar.
- Awaria przepuszcza na każdej ścieżce, decyzja idzie do logu.
Uczciwe zastrzeżenie: za problemem stoją liczby z pomiarów i trzydzieści dni historii produkcyjnej, ale sam bramkarz żyje na produkcji jeden dzień. Wiem, że odrzuca śmieci i zdejmuje czekanie na planer. Czy sąd wydany w 300 ms zgadza się z trzema czołowymi modelami dość często, by rozszerzać jego rolę — to zapytanie, którego jeszcze nie mogę wykonać, i zapisałem, czego wymaga odpowiedź, zanim zrobię z nim cokolwiek więcej.
Council działa na trycouncil.app, w App Store oraz w Google Play. Jeśli masz potok AI, który płaci pełną cenę za wejścia tego nie warte, i chcesz drugiej pary oczu na to, gdzie postawić taniego bramkarza — napisz do mnie.