
Pewność Claude, GPT i Gemini: najmniej pewny model w 222 sesjach Council
Trzy modele AI odpowiadają na to samo pytanie w tym samym promcie. Jeden jest najmniej pewny w 95% przypadków — i wcale nie jest tym przegłosowywanym.
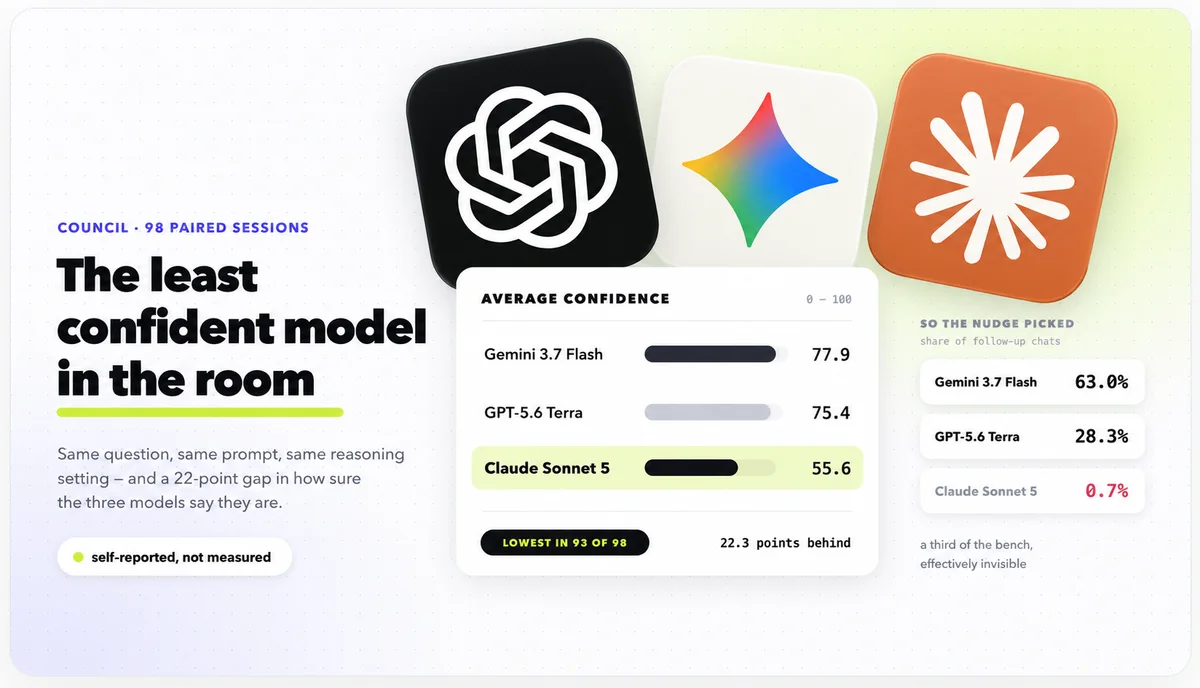
Council zadaje to samo pytanie trzem modelom AI i syntetyzuje z ich odpowiedzi jeden werdykt. Każdy model zwraca tę samą strukturę: rekomendację, uzasadnienie i pewność — liczbę od 0 do 100.
Ta liczba miała być najtańszym użytecznym sygnałem w całym produkcie. Przychodzi za darmo razem z odpowiedzią, za którą i tak płacę, jest jedną liczbą całkowitą i wydaje się znaczyć coś oczywistego. Sortowałem po niej. Dwa dni temu użyłem jej, żeby zdecydować, którego doradcę pokazać ludziom jako pierwszego.
Potem przeliczyłem to na wszystkich sesjach w bazie — i okazało się, że ta liczba nie znaczy tego, na co wygląda.
Dlaczego te sesje to uczciwe porównanie
Układ jest tu czystszy niż w większości porównań modeli, przy czym przypadkiem, a nie z zamysłu.
Każde miejsce przy stole dostaje identyczny prompt systemowy, identyczny schemat JSON, identyczne polecenie odpowiadania w języku użytkownika i identyczne najniższe ustawienie rozumowania u swojego dostawcy. Modele pracują równolegle nad tym samym pytaniem — nie benchmarkowym, tylko prawdziwym, które ktoś wpisał. Nic w tym układzie nie faworyzuje żadnego miejsca i nic się w nim nie zmienia poza samym modelem.
Spośród 222 sesji od czerwca w 98 przy stole siedział skład domyślny — cała trójka razem. To 98 porównań w parach: jedno wejście, trzy wyjścia, trzy deklaracje pewności.
Claude jest najmniej pewny w 95% przypadków
| Model | Średnia pewność | Najmniej pewny | Sesje z ≤50 |
|---|---|---|---|
| Gemini 3.7 Flash | 77,9 | 4 z 98 | 3 |
| GPT-5.6 Terra | 75,4 | 1 z 98 | 0 |
| Claude Sonnet 5 | 55,6 | 93 z 98 | 30 |
Claude Sonnet 5 był najpewniejszym uczestnikiem dokładnie w jednej sesji na 98. Średnia różnica między nim a Gemini, przy tym samym pytaniu, to 22,3 punktu.
Pierwsza myśl była taka, że to artefakt tego, kto pytał. W bazie jest konto z 50 sesjami, prawie na pewno moje własne testy — gdyby akurat zadawało pytania niewygodne dla Claude’a, mogłoby przeciągnąć cały wynik. Więc je usunąłem: zostają 93 sesje od 79 różnych osób, a średnie ledwie drgnęły — 78,0, 75,1, 55,1, przy czym Claude jest najmniej pewny w 89 na 93. To nie styl pytań jednej osoby. To model.
Oczywiste wyjaśnienie jest błędne
Ładna wersja brzmiałaby tak: Claude jest etatowym kontestatorem przy stole, jest mniej pewny, bo regularnie ląduje po stronie mniejszości, a niska pewność to uczciwy raport z bycia tym jedynym przeciw reszcie.
Dwie rzeczy w danych mówią co innego.
Żadne laboratorium nie jest nawykowym dysydentem. Kiedy syntezator opisuje, w czym panel się rozszedł, zwykle wskazuje, które laboratorium wyłamało się z szeregu. Na 222 sesje wskazuje OpenAI 163 razy, Google 158, a Anthropic 154. Trudno rozłożyć trzy liczby równiej. Niezgoda to nie jeden przeciw dwóm — jest realnie rozsmarowana po całym stole.
Pewność nie układa się w tej samej kolejności co zgoda. Gdyby wynik odzwierciedlał „zaraz zostanę przegłosowany”, najpewniejszy model najczęściej popierałby końcowy werdykt. Otóż nie:
| Model | Średnia pewność | Popiera werdykt |
|---|---|---|
| Gemini 3.7 Flash | 77,9 (najwyższa) | 82,4% |
| GPT-5.6 Terra | 75,4 | 91,7% (najwyższe) |
| Claude Sonnet 5 | 55,6 | 74,8% |
Gemini jest najpewniejszym uczestnikiem przy stole i zgadza się z resztą rzadziej niż GPT. Kolejności rozjeżdżają się dokładnie na górze — tam, gdzie prawdziwy sygnał musiałby się obronić.
Czyli ta liczba nie mierzy własności odpowiedzi. Mierzy własność laboratorium: to, jak dany model nauczono mówić o własnej pewności. Model Anthropic asekuruje się. Model Google nie. Postaw je obok siebie pod identycznym promptem, a czytasz dwa dialekty, nie dwa pomiary.
Chcę być precyzyjny, bo łatwo to przesadzić. Mowa o deklarowanej pewności, przy jednym promcie, na najniższym ustawieniu rozumowania u każdego dostawcy, na pytaniach o życiowe decyzje. To nie jest twierdzenie, że Claude jest gorszy, lepiej skalibrowany albo uczciwszy. Twierdzenie jest węższe i bardziej praktyczne: te liczby nie są porównywalne między dostawcami, więc każdy kod, który po nich rankuje modele, sortuje po stylu domu, nie po treści.
Czyli dokładnie to, co właśnie wdrożyłem.
Funkcja, którą zepsułem, wierząc własnej liczbie
Dzień przed tym zapytaniem wdrożyłem drobiazg do obu aplikacji. Czat z doradcą — gdzie można jeden na jeden dopytać jednego członka panelu — siedzi pod wszystkimi kartami ekspertów i prawie nikt nie przewijał tak daleko. Dodatkowe pytania pojawiły się kiedykolwiek w 12 sesjach na 222. Dodałem więc kartę bezpośrednio pod werdyktem: nazywa najostrzejszy spór i z góry wybiera doradcę, z którym warto podyskutować.
Którego doradcę? Najpewniejszego. Kiedy to pisałem, wydawało się to oczywiste: kieruj ludzi do tego, kto jest najbardziej pewny siebie.
Odtwarzam tę regułę na wszystkich 138 sesjach:
| Kogo wybrałaby karta | Udział |
|---|---|
| Gemini 3.7 Flash | 63,0% |
| GPT-5.6 Terra | 28,3% |
| Gemini 3.1 Flash-Lite | 7,2% |
| Claude Sonnet 5 | 0,7% — jedna sesja na 138 |
Zbudowałem funkcję, która kieruje praktycznie każdą rozmowę uzupełniającą do Google, na podstawie liczby mówiącej wyłącznie tyle, że model Google jest bardziej gadatliwy o własnej pewności. Jedna trzecia mojego własnego składu jest za nią niewidoczna. I działa to na produkcji w tej chwili. Nikt nigdy nie zgłosiłby tego jako błędu, bo z zewnątrz to po prostu karta z nazwą.
Naprawą nie jest lepsza funkcja rankująca po tej samej liczbie. Naprawą jest przestać po niej rankować: najciekawiej dyskutuje się z tym, kto się nie zgodził, a niezgodę widzę wprost w tablicy głosów i nie muszę jej wnioskować z samooceny.
Przy okazji: panel nie zgodził się ani razu
Z tego samego zapytania wypadły jeszcze dwie rzeczy, a jedna z nich to martwy kod, o którym nie wiedziałem, że go napisałem.
Karta ma gałąź, która ją ukrywa, gdy rada jest jednomyślna — nie ma wtedy sporu, na który można wskazać. Ta gałąź nigdy się nie wykonała. Ze 138 sesji w obecnym schemacie żadna nie ma pustej listy rozbieżności. Ani jedna. Przeciętna sesja niesie 3,1 jawnego sporu, a do tego:
- W 76% sesji głosy podzieliły się przy co najmniej jednej z trzech proponowanych opcji.
- W 38% nie było opcji, którą poparłyby wszystkie trzy modele.
- Wyniki konsensusu idą od 35 do 100, przy średniej 77,8.
Napisałem zabezpieczenie na przypadek, który w rzeczywistości nie istnieje. Trzy czołowe modele postawione przed prawdziwą decyzją i zobowiązane do rekomendacji za każdym razem znajdą o co się spierać.
Część, która uzasadnia produkt
Ostatnie odkrycie to takie, którego nie szukałem.
Pytania o karierę to zdecydowanie największa kategoria w Council — 29,3% wszystkich sesji, ponad dwa razy więcej niż następna. I jednocześnie kategoria, w której modele zgadzają się najmniej:
| Kategoria | Średni konsensus |
|---|---|
| Nauka | 93,9 |
| Zdrowie | 82,1 |
| Styl życia | 81,3 |
| Technologie | 76,3 |
| Pieniądze | 76,0 |
| Kariera | 72,4 |
| Twórczość | 69,6 |
To, co do czego ludzie najbardziej chcą drugiej opinii, jest dokładnie tym, gdzie odpowiedź jednego modelu najsłabiej reprezentuje to, co modele sądzą wspólnie. Gdyby panel zgadzał się co do kariery, Council byłby drogim sposobem na zrobienie tego, co już robi jedno wywołanie API. Nie zgadza się — więc nie jest.
To najmocniejszy argument za tym produktem, jaki mam, i nie wymyśliłem go —
znalazłem go w GROUP BY.
Uczciwe zastrzeżenia
To 222 sesje od 109 osób, z czego trzy płacą. Próbka jest mała. Część wczesnych sesji to moje własne wielojęzyczne testy tego samego przykładowego pytania. Za kilkoma wierszami tabeli kategorii stoi mniej niż 20 sesji i ani przez chwilę nie broniłbym różnicy między zdrowiem a stylem życia.
Ale główny wynik nie potrzebuje dużej próbki, tylko sparowanej — a 93 na 98, utrzymujące się jako 89 na 93 u 79 niepowiązanych osób, to nie artefakt doboru. Podobnie jak funkcja kierująca 0,7% ruchu do jednej trzeciej własnego składu.
Co powiedziałbym każdemu, kto buduje na więcej niż jednym modelu
Nie porównujcie deklarowanej pewności między dostawcami i nigdy nie pozwólcie jej sterować routingiem, rankingiem, kolejnością ani tym, kto ma ostatnie słowo. Wewnątrz jednego modelu może jeszcze coś znaczyć — własne 15 i własne 95 u Claude’a prawdopodobnie znaczą co innego. Między modelami to przelicznik jednostek, którego nikt nie zdefiniował, a kod traktujący te liczby jako wymienne po cichu dorobi się ulubionego laboratorium.
Szerszy wniosek jest starszy i nudniejszy niż samo odkrycie. Wdrożyłem regułę routingu jednego dnia, bo była oczywiście słuszna, i obaliłem ją następnego zapytaniem, które mogłem wykonać wcześniej. Zapytanie zajęło cztery minuty. Wszystko, czego potrzebowało, leżało już w bazie — nietknięte, przez cały czas, gdy funkcja powstawała i przechodziła review.